Reference → Generate → Edit → Extend
素材と制作意図を一本の流れでつなぎ、試作から最終映像までコントロールします。
 Seedance 2.5
MULTIMODAL VIDEO GENERATION / 2026
長尺ストーリーテリング × 高い参照精度 × 精密な編集 × 多言語対応
画像・動画・音声を最大50点まで参照し、最長30秒の生成、プロ品質の編集・延長、 10以上の言語によるストーリーテリングを、ひとつの制作フローで。
HIGH-FIDELITY PREVIS → FINAL OUTPUT SEEDANCE 2.5
1本の完成度だけでなく、再利用しやすく、納品可能な品質を保ち、規模を拡大できる映像制作へ。
素材と制作意図を一本の流れでつなぎ、試作から最終映像までコントロールします。
長い物語を、一度の生成で。
画像・動画・音声を横断。
グローバルな制作現場へ。
人物・モーション・スタイル・音声・絵コンテ・キーフレームを横断し、素材の特徴と構成を高精度に引き継ぎます。
被写体、衣装、背景、表情、カメラ、音声を、時間範囲まで指定して編集。変えない部分はそのまま維持します。
映像と音声の一貫性を保ちながら前後へ延長。異なる動画間のシームレスなトランジションにも対応します。
複数の画像や動画から、文字・スタンプ・トランジションを含むショートムービーを生成します。
ホワイトモデルの構造と演出を引き継ぎ、同期した完成映像へレンダリング。
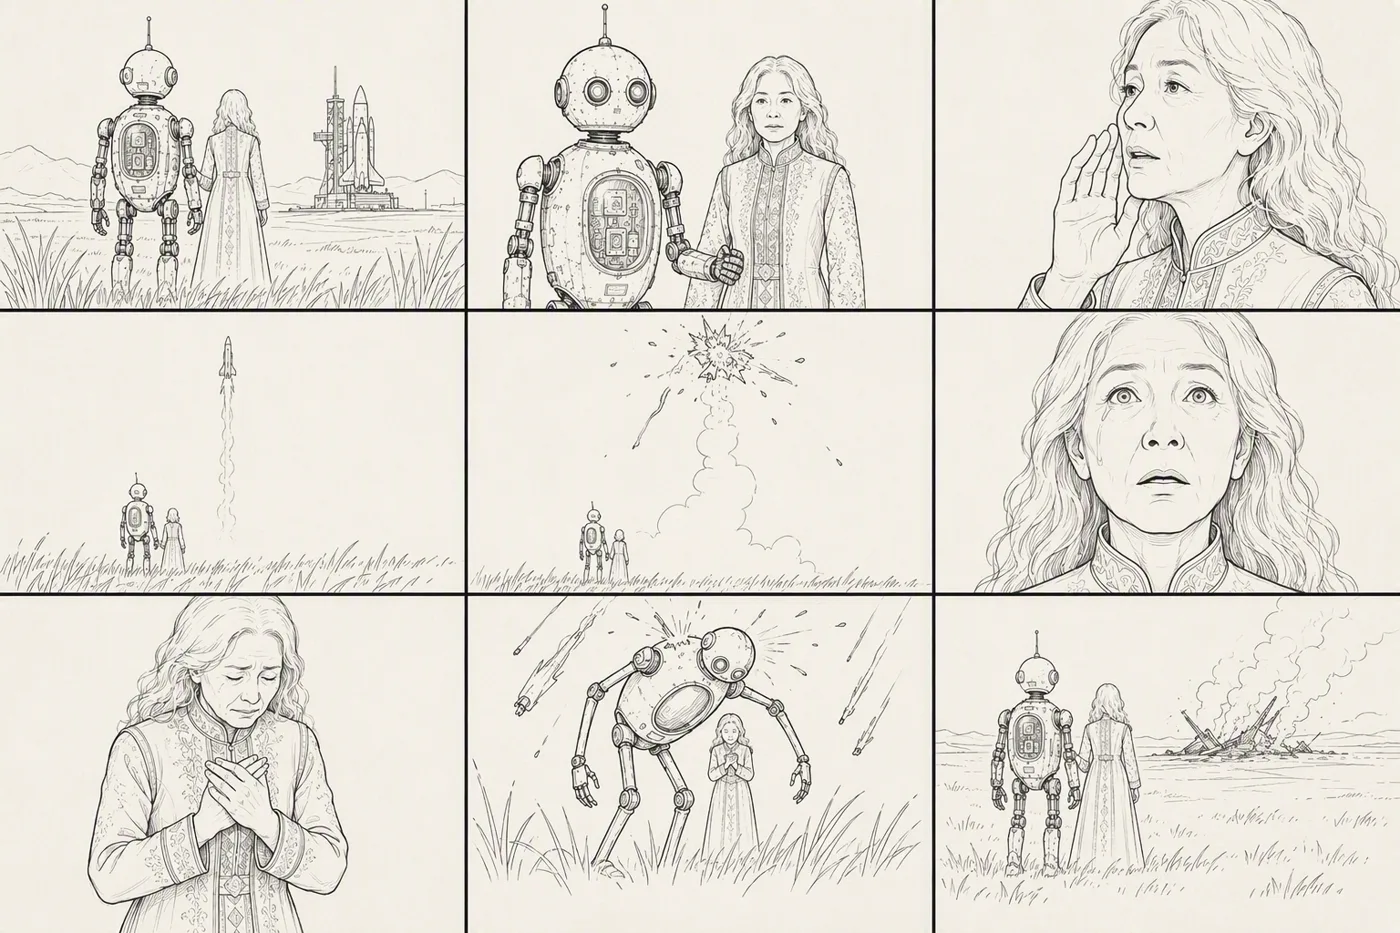
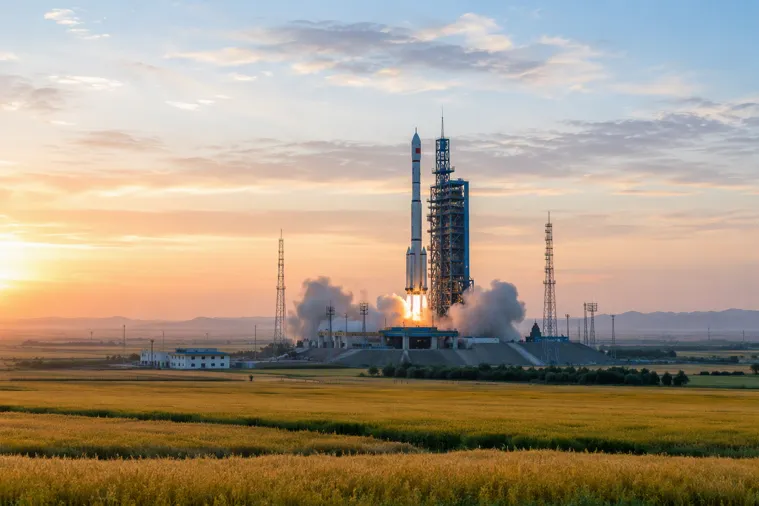
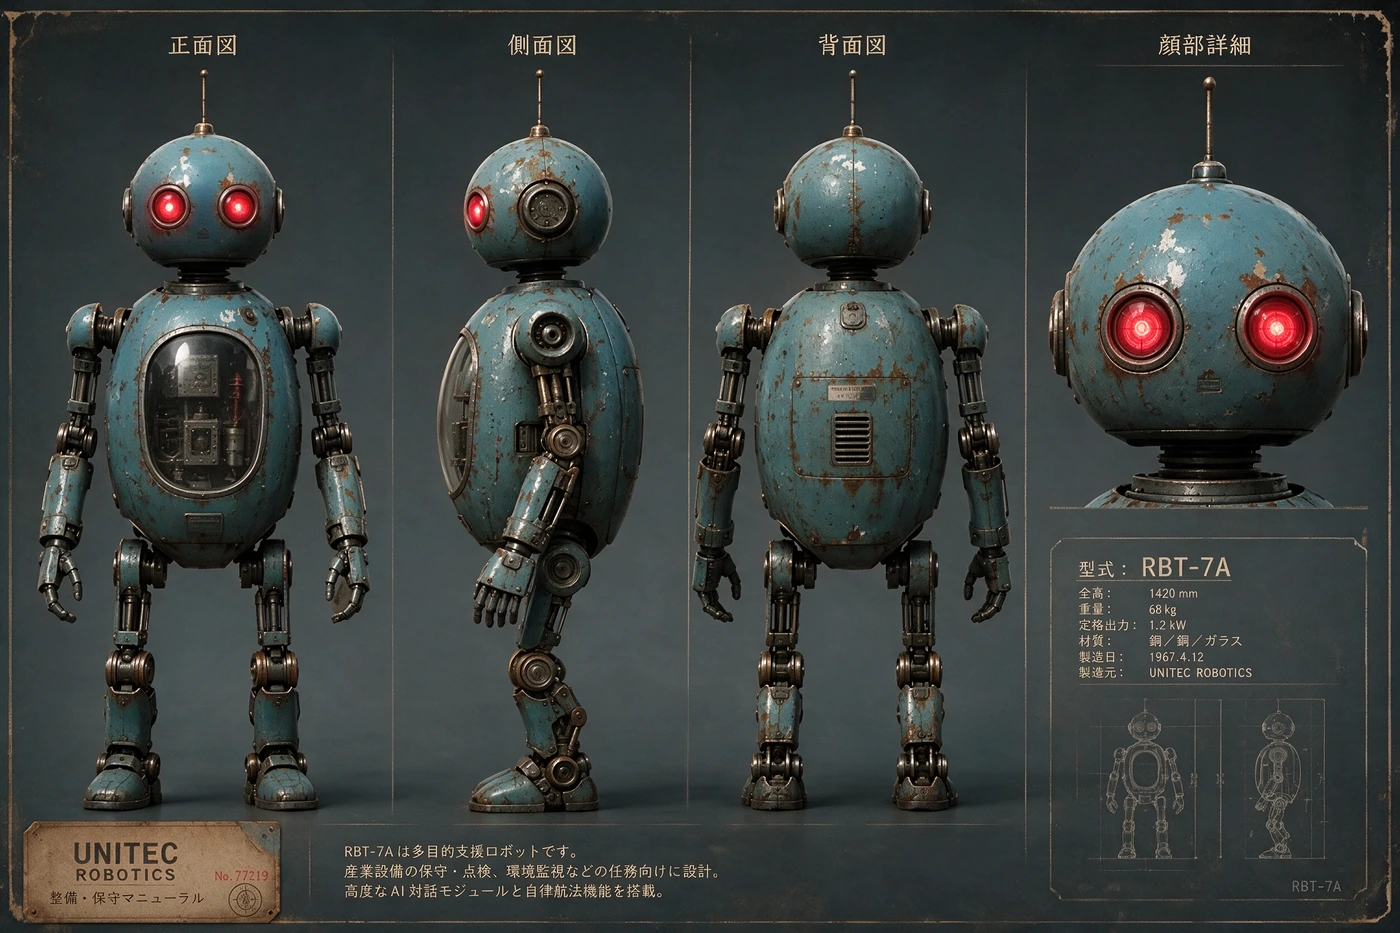
絵コンテの構図、動き、物語に、環境とキャラクターの参照素材を組み合わせます。
画像・動画・音声に番号を付け、何を参照するかを明記。
被写体+場所+出来事+ジャンル/スタイル+カメラ。
整数秒のタイムスタンプで、映像・カメラ・動作・セリフ・音を設計。
全編で維持する画角、光、音、雰囲気、品質を指定。
変更範囲を指定して編集・延長し、納品品質へ。
構図・カメラ・照明・タイミングを保ちながら、対象と時間範囲を指定して変更します。
EDIT INSTRUCTION「構図、カメラ、照明、タイミングは維持。女性を20代から60代へ。涙はやがて笑顔に変わる。」
アップロードした2本の映像の間を推論し、自然なブリッジを生成。
複数素材からSNSフォーマットへ。
場所・衣装・被写体を参照画像でコントロール。
日本語のセリフと、字幕なしの自然な口の動きを同期。
抽象的な願望より、素材の役割、見える動作、時間、変えない要素を具体的に。
画像1の人物、動画2のカメラワーク、音声3のメロディを参照。
被写体+場所+出来事+スタイル+特別なカメラ移動。
[0–3秒] 映像・カメラ・動作・セリフ・SFXを整数秒で設計。
光、画角、音、ムード、連続性、品質。「字幕なし」「BGMなし」。
素材数を増やすだけでなく、それぞれの参照先を明確にすることが安定した制作の鍵です。
1点あたり最大4K
合計30秒まで
合計30秒まで
1回の入力上限
被写体:画像 1–8 / 音声・動画 1–5
絵コンテ:15コマ以内・文字は少なく
動画編集:20秒以内
Seedance 2.5 マルチモーダル動画生成ユーザーガイドで、タスクの選び方、素材の準備、プロンプト、活用例を確認できます。